

数据是训练 AI 的原材料,模型的一切知识都来自训练数据。数据的质量、数量、多样性直接决定模型能力上限——垃圾数据只能训练出垃圾模型,这是 AI 领域最朴素的真理。
一个常被忽视的事实:模型不会“创造”知识,它只是重新组合见过的数据。因此当训练数据里某类信息缺失,模型在这块就会表现愚蠢。这也是为什么专业领域 AI 需要领域数据——医疗、法律、金融的 AI 壁垒往往在数据而不在算法。
## 核心要点
图片来源:Openverse / ccPixs.com(https://www.flickr.com/photos/86530412@N02/14796090251)
1. 高质量数据比大数据量更重要,噪声数据会系统性误导模型。
2. 公开互联网数据正在被消耗殆尽,合成数据成为新方向。
3. 数据偏见会直接继承到模型输出,造成公平性问题。
4. 数据治理与合规(如个人信息保护)是 AI 落地的硬约束。
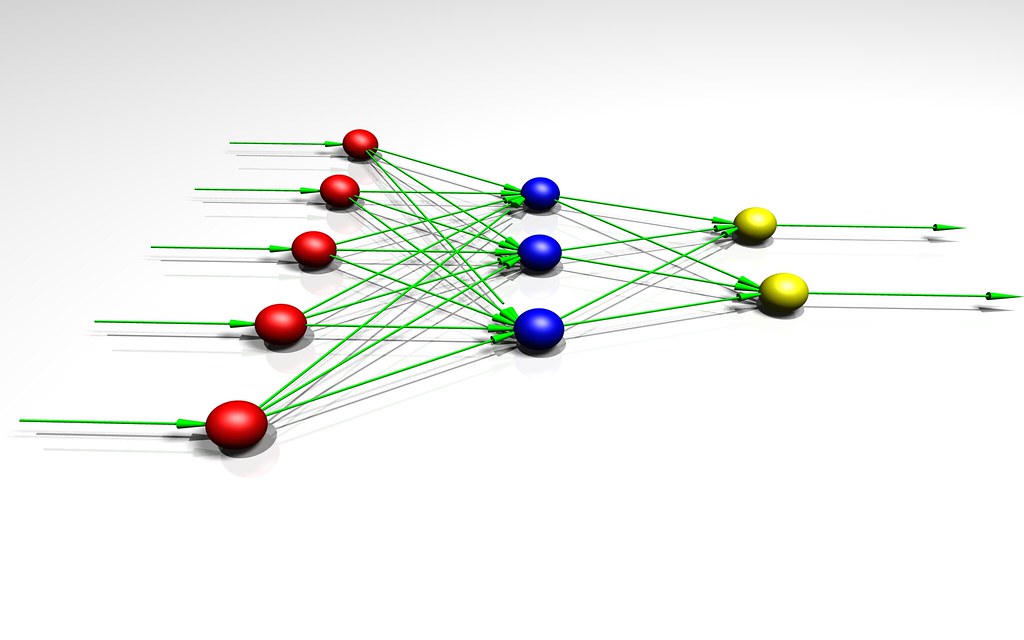
图片来源:Openverse / fdecomite(https://www.flickr.com/photos/21649179@N00/3237928173)
## 写在最后
以上是关于「数据」的科普介绍。人工智能正在快速发展,相关概念和方法也在不断演进。希望本文能帮你建立对这一主题的基本认识。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END









请登录后查看评论内容