深度伪造检测:真假之间的军备竞赛
检测深度伪造的技术与生成技术你追我赶:AI 检测器找破绽,生成器补破绽,循环往复。这场军备竞赛没有终局,核验机制成为关键防线。 这场竞赛最深远的影响是:真实变成了奢侈品。当“看到”不再...
 8小时前
神经网络的可解释性:我们离懂它还有多远
深度模型为何有效?内部那几十亿个数字在做什么?可解释性研究试图回答这些问题。目前我们有了显微镜(注意力图、探针实验),但离真正的“理解”还很远。 可解释性是 AI 领域最深刻的科学问题...
8小时前
可解释 AI:打开黑箱的努力
可解释 AI(XAI)致力于让模型决策过程可被人类理解:为什么拒绝这笔贷款?为什么诊断为这个病?它不只是技术追求,更是公平、信任与合规的必要条件。 可解释性的深层意义是权力制衡:如果机器...
8小时前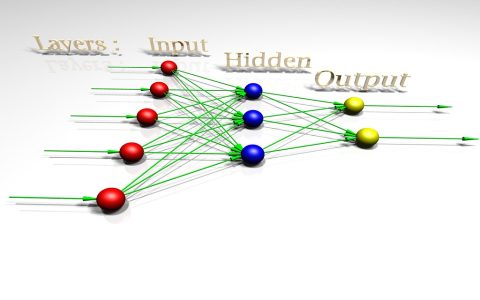
AI 幻觉:AI 安全的头号问题
AI 幻觉指模型编造不存在的事实——虚构论文、错误数据、不存在的产品接口。它是大模型最危险、也最难根除的缺陷,是所有生产环境必须直面的头号问题。 与幻觉共处需要的不是信任,而是机制。最...
8小时前
深度伪造:当视频不再可信
深度伪造(Deepfake)让任何人都能生成以假乱真的音视频:名人说过没说过的话、政要做过没做的事。它打击的是人类文明的基础设施——“眼见为实”。 深度伪造最深远的影响是“信任通胀”:当一...
8小时前
AGI 风险:该担忧还是该期待
如果 AGI 真的到来,它可能是人类最好的发明,也可能是最后一个。目标不一致的超级智能可能带来存在性风险——这个担忧已被包括奥特曼、辛顿在内的顶尖科学家严肃提出。 AGI 风险讨论最有价值的...
8小时前
AI 对齐:让机器的价值观与人类一致
对齐(Alignment)是确保 AI 系统的目标、行为与人类价值观一致的技术努力。一个能力强但目标错误的 AI 会造成巨大危害——这正是对齐问题被提升到战略高度的原因。 对齐问题之所以困难,是因为...
8小时前
