数据标注:被低估的关键环节
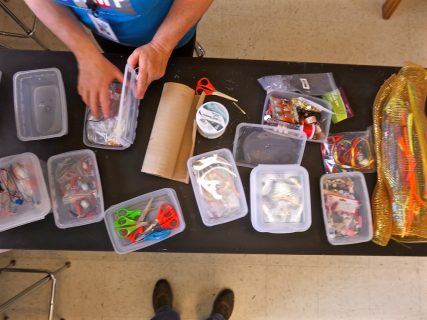
数据标注是给原始数据贴标签的过程:这张图里是猫还是狗、这条评论是正面还是负面。它是监督学习的燃料,也被称为“AI 行业里最苦的活”。 数据标注行业藏着 AI 繁华背后的另一面:全球有数以百...
 9小时前
特征工程实战:让数据更好用
特征工程是把原始数据加工成模型可用特征的技术:时间戳拆成“星期几”“是否节假日”,地址转成经纬度与到地铁站的距离。它决定了模型看到的世界长什么样。 特征工程最像做菜:同样的食材(数...
9小时前
语料库:NLP 研究的数据基石
语料库是按特定标准收集的语言数据集合:维基百科语料、新闻语料、对话语料。没有大规模语料库,就没有统计 NLP 与深度学习 NLP 的今天。 语料库是语言学的“实验室”:关于语言的一切假设,都...
9小时前
数据:AI 的燃料与枷锁
数据是训练 AI 的原材料,模型的一切知识都来自训练数据。数据的质量、数量、多样性直接决定模型能力上限——垃圾数据只能训练出垃圾模型,这是 AI 领域最朴素的真理。 一个常被忽视的事实:模...
9小时前
