

MoE(Mixture of Experts)把模型拆成多个“专家”子网络,每次推理只激活其中少数几个。这样既保持了总参数带来的能力,又大幅降低了实际计算量。
MoE 的思想非常人性化:就像医院分科,病人来了先挂号(路由),再由对应科室的医生(专家)处理。没人需要所有医生同时上班,模型也一样——按需激活才是效率之道。
## 核心要点
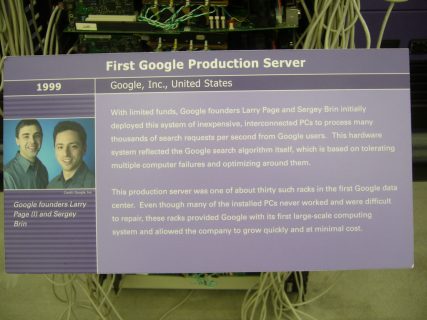
图片来源:Openverse / jiuguangw(https://www.flickr.com/photos/32366606@N00/4982413010)
1. MoE 的总参数可以很大,但单次推理只用到一小部分。
2. DeepSeek、Mixtral 等模型采用 MoE 架构实现高性价比。
3. 路由机制是 MoE 的关键:决定每个 token 由哪个专家处理。
4. MoE 的训练更复杂,负载均衡是需要攻克的难点。
图片来源:Openverse / surRANTo dwi saputra(https://www.flickr.com/photos/125321218@N07/23793808619)
## 写在最后
以上是关于「MoE」的科普介绍。人工智能正在快速发展,相关概念和方法也在不断演进。希望本文能帮你建立对这一主题的基本认识。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END








请登录后查看评论内容