

语言模型的本质是:给定上文,输出下一个 token 的概率分布。它不“思考”,只是基于训练数据中的统计规律做高概率的续写。理解这一点,是理解它所有优点与缺点的钥匙。
接受“AI 是概率机器”这个事实,是与它高效协作的前提。不要问它“你确定吗”,要问“你的依据是什么”。把它当一个口齿伶俐但没有责任心的叙述者,用外部知识核查它的关键陈述,这才是成熟的用法。
## 核心要点
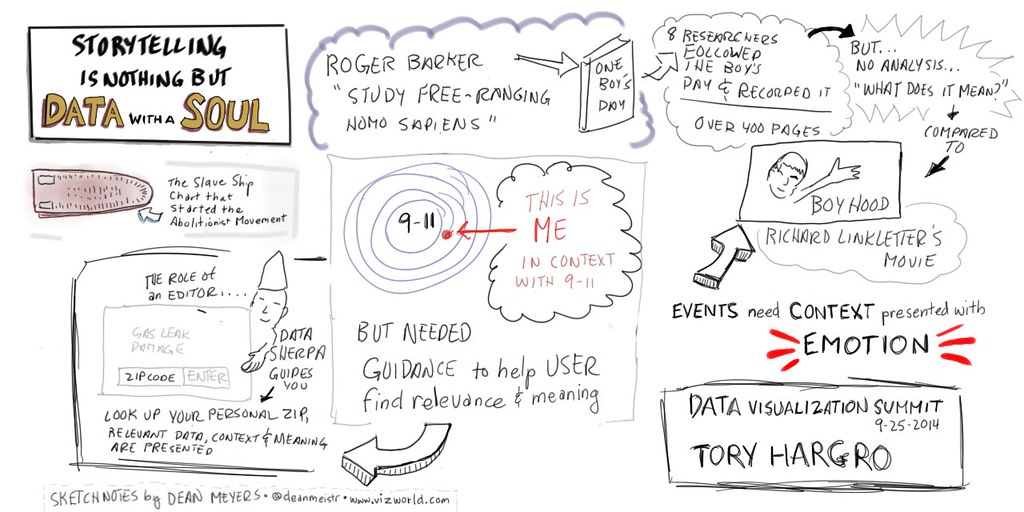
图片来源:Openverse / Dean Meyers(https://www.flickr.com/photos/36363318@N04/15166752228)
1. 它选择高概率的词,所以输出总是“听起来合理”的。
2. 概率高不等于事实正确,这是幻觉的根本来源。
3. “采样”引入随机性,所以同一问题答案每次不同。
4. 它对“不可能”毫无概念,自信地说出不存在的事。
图片来源:Openverse / David Alexander Elder(https://www.flickr.com/photos/62606625@N05/20365098860)
## 写在最后
以上是关于「语言模型的概率」的科普介绍。人工智能正在快速发展,相关概念和方法也在不断演进。希望本文能帮你建立对这一主题的基本认识。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END








请登录后查看评论内容