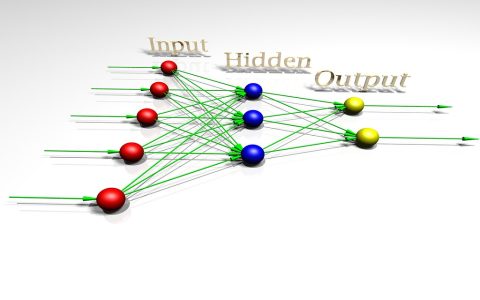


DeepSeek 在 2025 年初以极低成本训练出媲美顶级闭源模型的 R1,并完全开源,引发全球震动。它证明了算法创新可以部分替代算力堆叠,一度让英伟达市值单日蒸发数千亿美元。
DeepSeek 给整个行业上了一课:当资源受限时,创新反而可能被激发。它也打破了“算力即一切”的迷思,让所有人重新审视 AI 发展的路径依赖。技术革命常常来自边缘,这大概是最好的例证。
## 核心要点
图片来源:Openverse / Cory M. Grenier(https://www.flickr.com/photos/26087974@N05/11387253605)
1. DeepSeek-V3 的训练成本只有同级别模型的零头。
2. MoE 架构 + 多头潜在注意力是它的核心创新。
3. R1 的强化学习路线绕过了对昂贵人工标注的依赖。
4. 完全开源(含论文与训练细节)展现了巨大的技术自信。
图片来源:Openverse / Peter Alfred Hess(https://www.flickr.com/photos/22799676@N03/5018046965)
## 写在最后
以上是关于「DeepSeek」的科普介绍。人工智能正在快速发展,相关概念和方法也在不断演进。希望本文能帮你建立对这一主题的基本认识。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END








请登录后查看评论内容