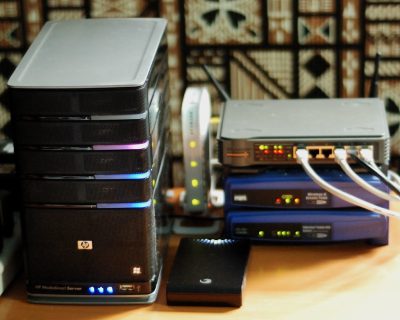


在 notebook 里跑通模型只完成了 20% 的工作。部署到生产环境,要解决 API 封装、负载均衡、版本管理、监控告警、A/B 测试、回滚机制——这些才是真正决定项目成败的部分。
研究员与工程师的最大差异,就在这一步:前者追求“效果好”,后者追求“一直好用”。生产环境的复杂度远超实验室,能把模型稳定跑起来的团队,比能训出好模型的团队更稀缺。
## 核心要点
图片来源:Openverse / JD Hancock(https://www.flickr.com/photos/83346641@N00/12403313305)
1. 模型服务化需要考虑延迟、吞吐与稳定性。
2. 数据漂移监控是上线后的第一要务。
3. 灰度发布让风险可控,是成熟团队的标准动作。
4. MLOps 工具链正在快速成熟,值得投入。
图片来源:Openverse / europeanspaceagency(https://www.flickr.com/photos/37472264@N04/29297633637)
## 写在最后
以上是关于「模型部署」的科普介绍。人工智能正在快速发展,相关概念和方法也在不断演进。希望本文能帮你建立对这一主题的基本认识。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END












请登录后查看评论内容