

文本相似度计算两段文本在语义上有多接近。查重、搜索、推荐、客服路由,都建立在它之上。从字面匹配到语义匹配,是 NLP 进化的主线之一。
“相似”这个概念远比想象中复杂:王之涣的《登鹳雀楼》与一首现代励志歌,字面完全不同,主题高度相似。判断深层相似需要理解而非比较——这正是 AI 从匹配走向理解的完整历程。
## 核心要点
图片来源:Openverse / stuart.childs(https://www.flickr.com/photos/24001581@N07/10978555856)
1. 编辑距离只看字面,词向量看语义,大模型看深层含义。
2. 句向量模型(Sentence-BERT)是语义检索的实用方案。
3. “相似”在不同场景定义不同:近义、相关、同事实。
4. 它是 RAG 系统能否检索准的核心。
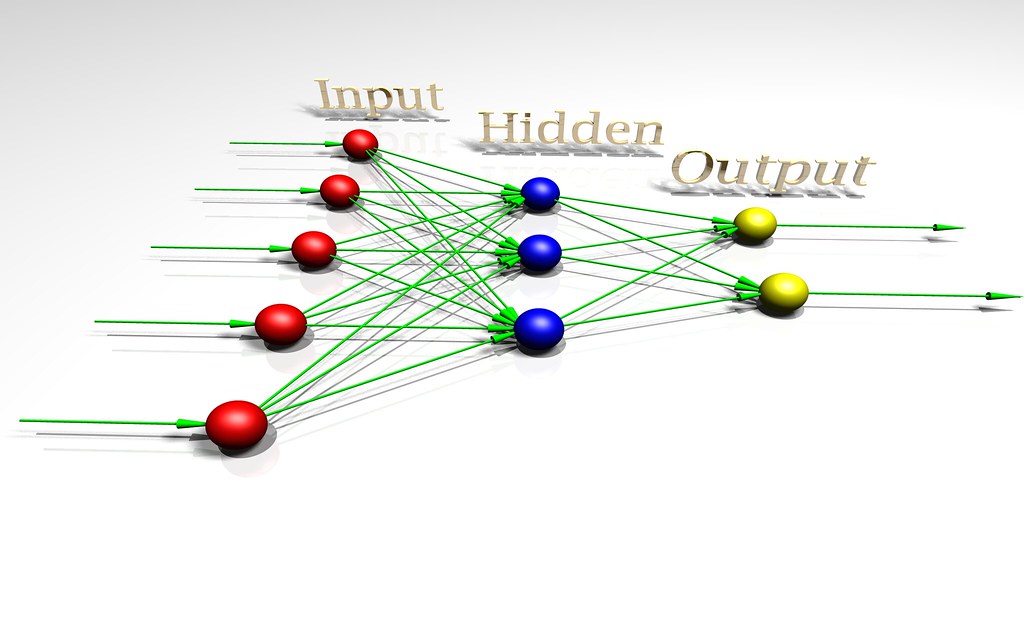
图片来源:Openverse / fdecomite(https://www.flickr.com/photos/21649179@N00/3238821080)
## 写在最后
以上是关于「文本相似度」的科普介绍。人工智能正在快速发展,相关概念和方法也在不断演进。希望本文能帮你建立对这一主题的基本认识。
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END









请登录后查看评论内容